SRCNN
- 제목: Learning a Deep Convolutional Network for Image Super-Resolution
- 저자: Chao Dong 외 3명
- 학회: ECCV 2014
- 논문 링크: SRCNN 논문 보기
SRGAN
- 제목: Photo-Realistic Single Image Super-Resolution Using a Generative Adversarial Network
- 저자: Christian Ledig 외 10명
- 학회: CVPR 2017
- 논문 링크: SRGAN 논문 보기
ESRGAN
- 제목: ESRGAN: Enhanced Super-Resolution Generative Adversarial Networks
- 저자: Xintao Wang 외 7명
- 학회: ECCV Workshops 2018
- 논문 링크: ESRGAN 논문 보기
추가 소속: SRCNN — CUHK & Microsoft Research / SRGAN — Twitter / ESRGAN — CUHK-SenseTime Joint Lab et al.
https://youtu.be/unf2ziKXBP4?si=a55ZF0ql6uVeaioE\
논문 읽기 전
배경 지식이 훨씬 중요하기도 하고
오늘 신입분들이 새로 들어오기도 하기 때문에
SR의 배경부터 자세히 설명하도록 하겠습니다
제가 논문 이미지 말고 강의 자료 사용하는 것은 위 링크의 김성범 교수님의 설명 + 강의 자료를 참고했습니다!!
Super-Resolution은 단순 확대가 아니다
· Single Image Super-Resolution (SISR): 한 장의 LR 이미지로 HR 이미지를 추정하는 문제
· 핵심 질문: “없는 고주파 정보를 어떻게 그럴듯하게 복원할 것인가?”
!단순히 256×256 이미지를 1024×1024로 resize하는 것과 super-resolution은 같은 문제가 아닙니다!
LR · HR · SR 용어와 학습 데이터
· HR: 원래의 고해상도 정답 이미지
· LR: HR을 blur/downsample하여 만든 입력 이미지
· SR: 모델이 LR로부터 출력한 super-resolved 이미지
· 실험에서는 HR로부터 LR을 합성해 paired data를 만드는 경우가 많음

왜 SR은 ill-posed인가: one-to-many 문제
· downsampling은 정보 손실이 있는 non-invertible operation
· 같은 LR patch를 만들 수 있는 HR texture가 여러 개 존재
· 따라서 SR은 “정답 픽셀을 계산”하는 문제가 아니라 prior를 이용한 inference 문제
전통적인 Upsampling 1: interpolation은 무엇을 하는가
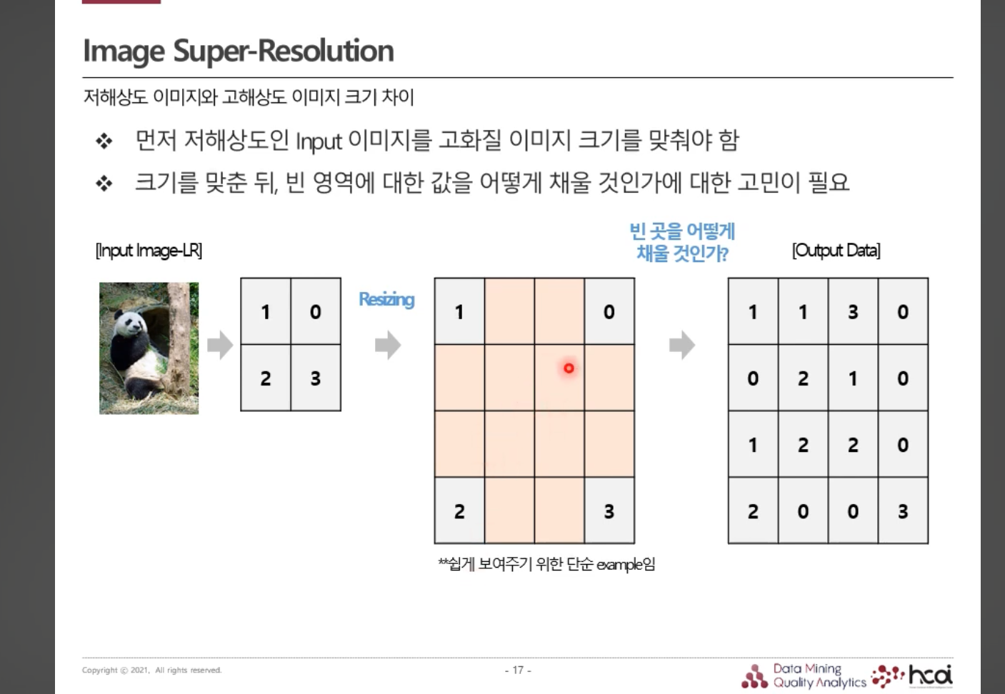
· 저해상도 이미지와 고해상도 이미지의 크기가 다르기 때문에, 먼저 입력 이미지를 목표 크기에 맞춰야 함
· 크기를 맞춘 뒤에는 비어 있는 픽셀 값을 어떤 방식으로 채울 것인지가 핵심 문제
· 이 뒤에서 interpolation 기반 방법과 learning-based upsampling 방법으로 나누어 설명 가능
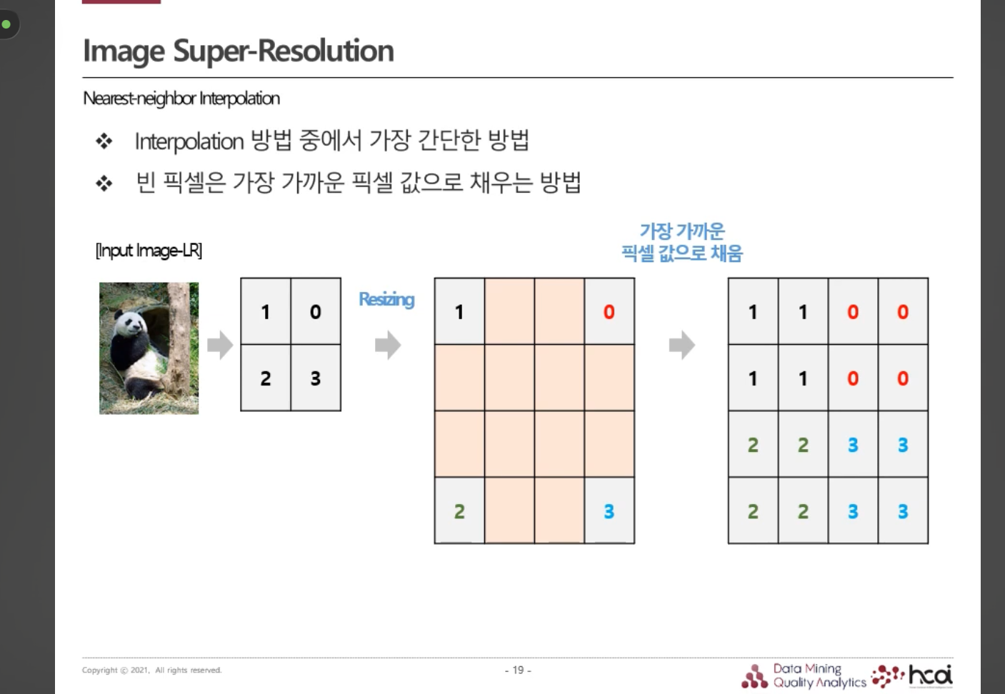
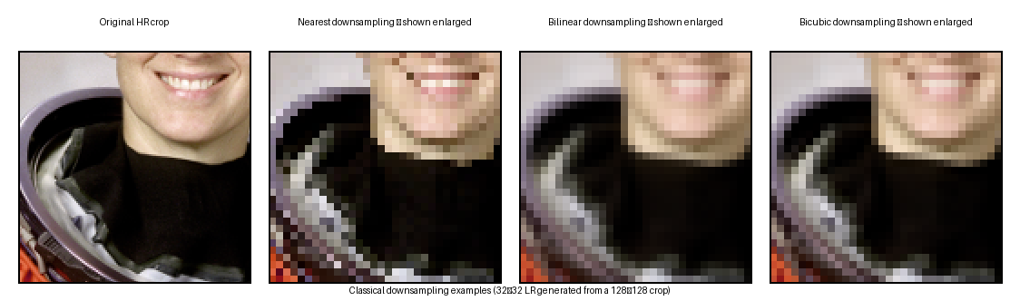
· Interpolation 방법 중 가장 단순한 방식
· 빈 픽셀을 가장 가까운 기존 픽셀 값으로 채움
· 연산은 간단하지만 blocky하고 계단 현상이 잘 보일 수 있음
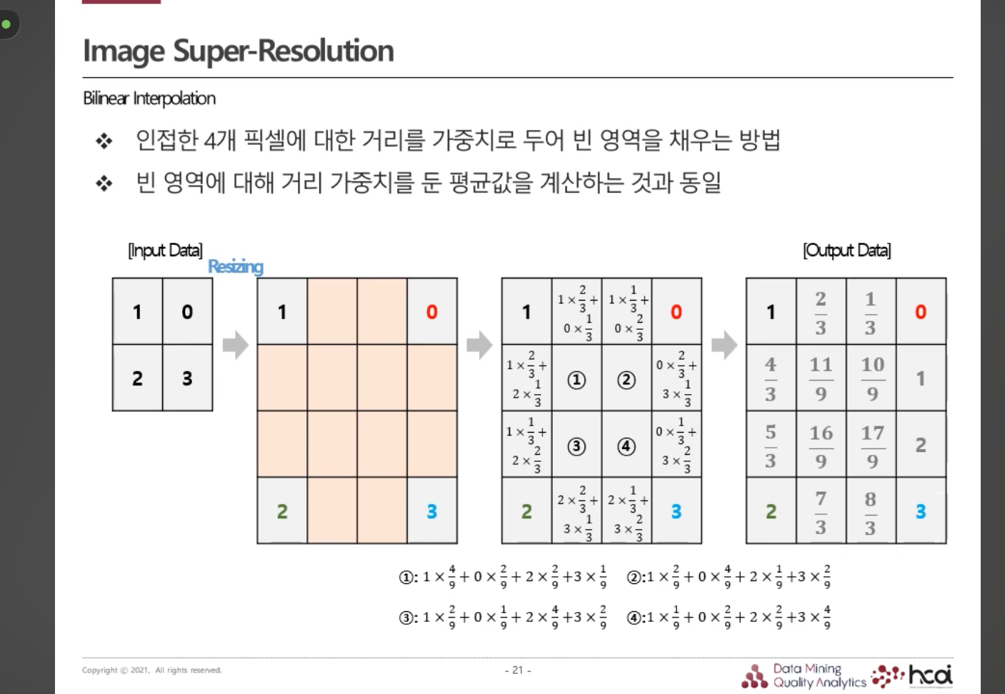
· 빈 픽셀 값을 주변 4개 픽셀의 거리 가중 평균으로 계산
· 가까운 픽셀일수록 더 큰 가중치를 가짐
· Nearest-neighbor보다 더 연속적이고 부드러운 값을 만듦
· 다만 여전히 고정된 수학적 규칙이지, 학습을 통해 새로운 detail을 복원하는 것은 아님
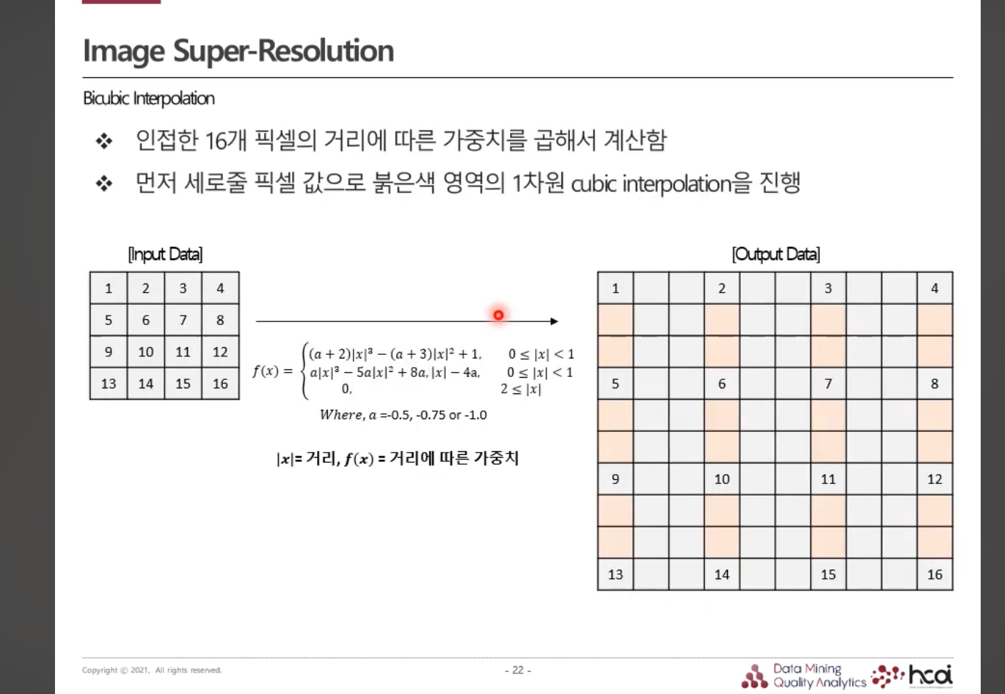
· 이번에는 4개가 아니라 인접한 16개 픽셀 정보를 사용
· 거리 기반 cubic function을 이용해 값을 계산
· 먼저 세로 방향으로 1차 cubic interpolation을 수행
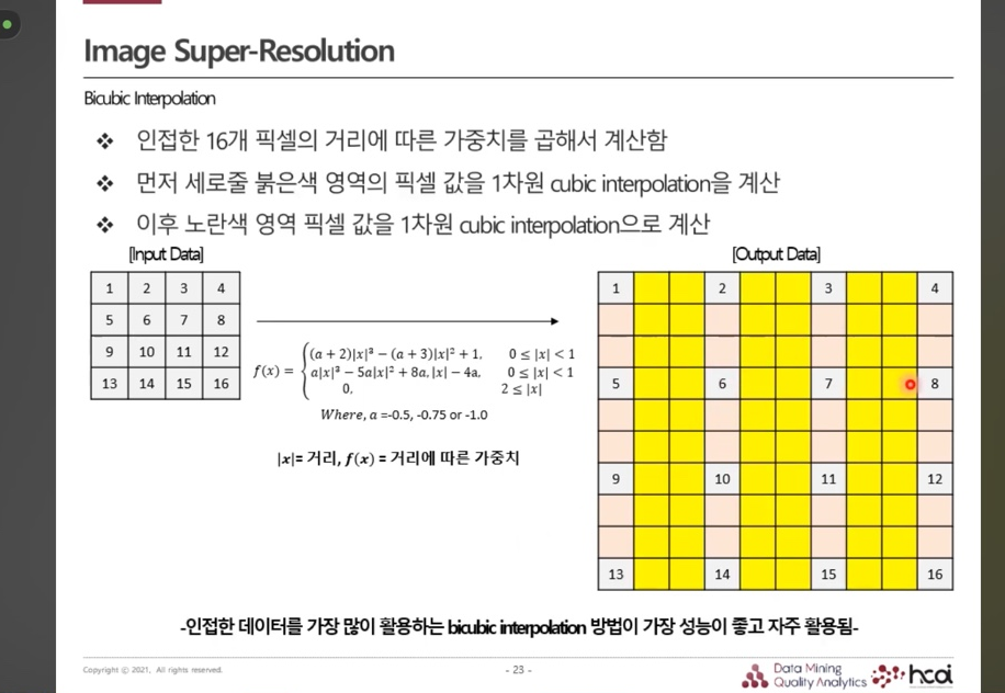
· 세로 방향 계산 후, 노란색 영역에 대해 가로 방향 1차 cubic interpolation을 추가 수행
· 결국 16개 주변 데이터를 활용해 보다 자연스러운 값을 생성
· 고전적 interpolation 방법들 중에서는 성능이 좋고 자주 활용되는 편
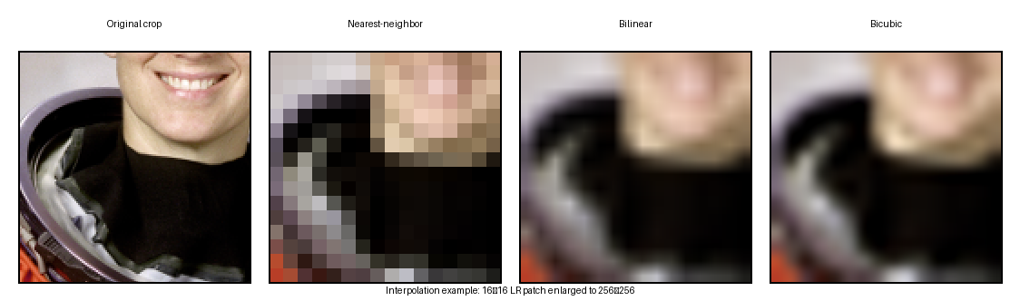
Upsampling 2: interpolation이 아니라 업샘플링 레이어 자체의 파라미터를 학습하는 방법
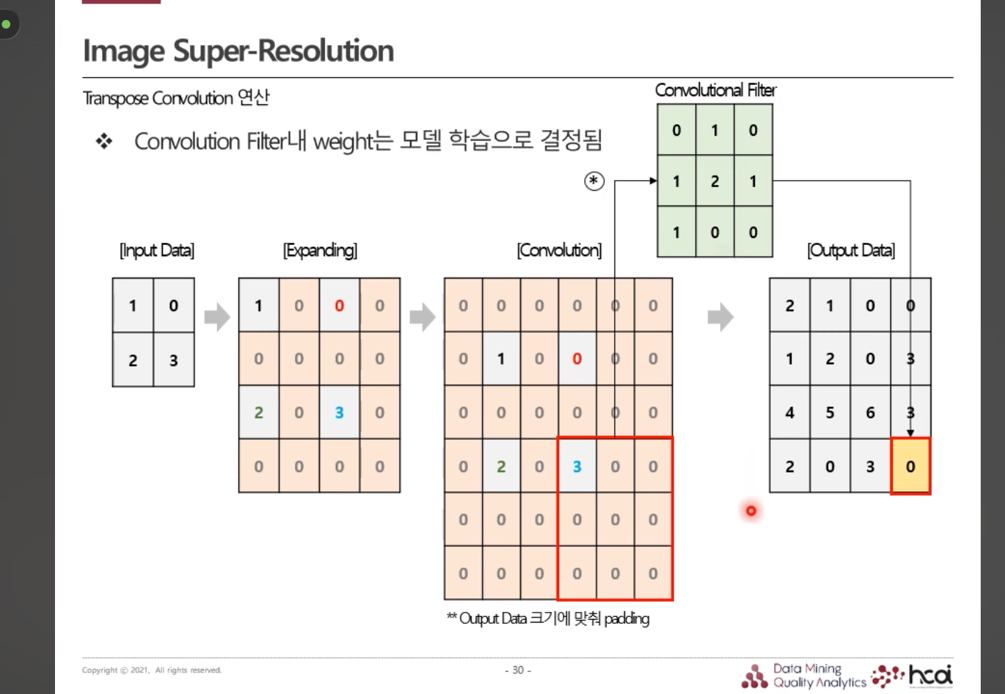
· 공간을 먼저 확장한 뒤, convolution filter를 적용해 출력값 생성
· filter weight는 사람이 정하는 것이 아니라 모델 학습으로 결정됨
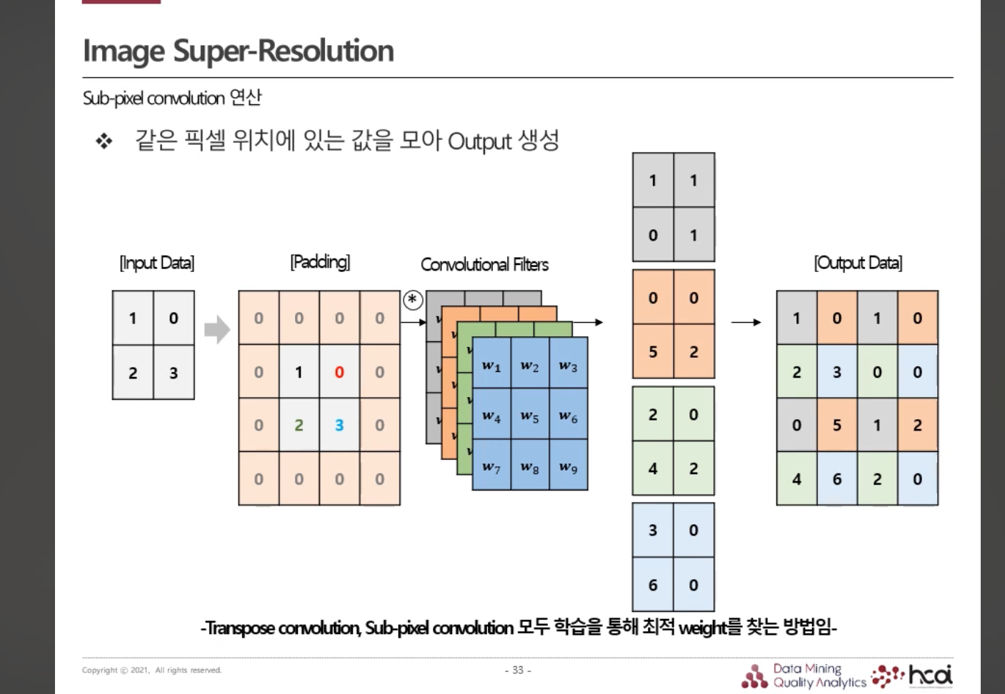
· LR 공간에서 convolution을 수행한 뒤, 출력 채널들을 재배열해서 HR 이미지를 생성하는 방식
· 같은 위치에서 나온 값들을 모아 최종 output 픽셀로 배치
· Transpose convolution과 마찬가지로 학습을 통해 최적 weight를 찾지만, 연산 구조가 다름
사전 지식: 알아야 하는 지표들
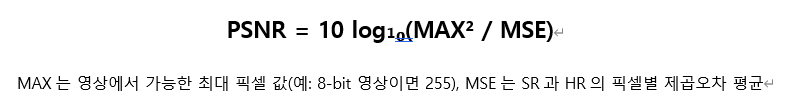
· PSNR = Peak Signal-to-Noise Ratio
· 예측 SR과 정답 HR의 픽셀 차이를 MSE로 계산하고, 그 MSE를 이용해 영상 복원 품질을 수치화
· MSE가 작을수록 PSNR은 커지므로, 같은 평가 조건에서는 PSNR이 높을수록 HR과 픽셀 값이 가깝다는 의미
· 보통 dB 단위로 표시
· PSNR과 SSIM은 기본적으로 평가 지표(metric)이고, MSE는 학습 loss로 직접 사용되는 경우가 많음
!참고로 이것은 SRGAN의 perceptual quality와 연결된다!
· SSIM = Structural Similarity Index
· 픽셀 하나하나의 오차만 보지 않고 luminance(휘도), contrast(대비), structure(구조)를 비교
· 평균, 분산, 공분산을 사용해 두 이미지의 국소적 구조가 얼마나 유사한지 평가
· 보통 값이 클수록 구조적으로 더 유사하며, 동일한 이미지에서는 1
· PSNR보다 인간의 시각적 구조 인식에 가까운 관점을 포함하지만 perceptual quality 전체를 완벽하게 설명하지는 못함
| 비교 요소 | 무엇을 보는가 | 쉽게 말하면 |
| Luminance | 평균 밝기 | 전체적으로 밝고 어두운 정도가 비슷한가? |
| Contrast | 분산/표준편차 | 명암 차이와 대비가 비슷한가? |
| Structure | 공분산 기반 관계 | edge, texture 등 구조적 패턴이 비슷한가? |
이제 본격적으로 오늘 리뷰할 세 논문으로 넘어가도록 하겠습니다.
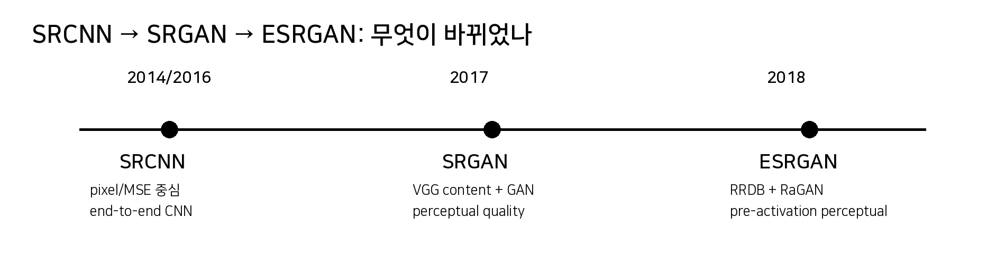
· SRCNN: CNN으로 LR→HR mapping을 end-to-end 학습
· SRGAN: pixel fidelity만이 아니라 perceptual realism을 loss에 반영
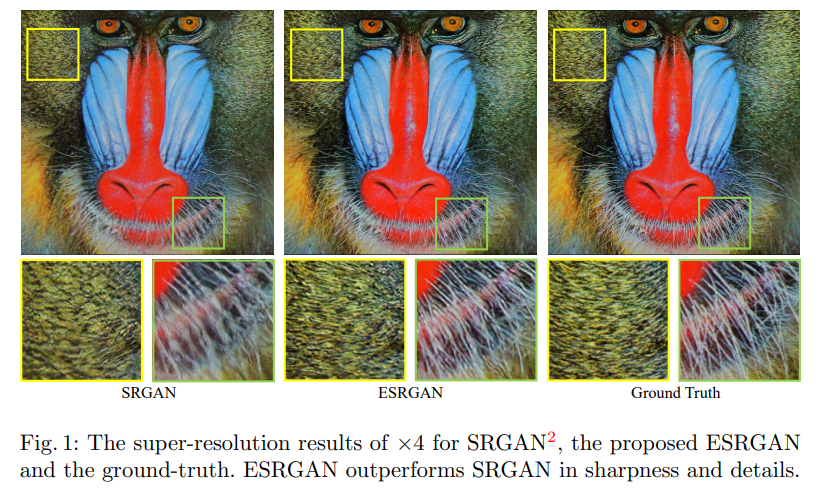
· ESRGAN: SRGAN의 architecture · adversarial loss · perceptual loss를 모두 개선
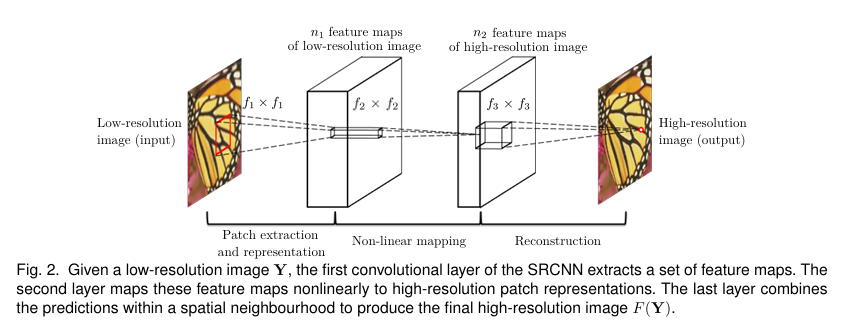
· 입력: bicubic으로 HR 크기까지 미리 키운 LR
· Layer 1: patch extraction & representation — 기본 설정 9×9, 64 maps
· Layer 2: non-linear mapping — 1×1, 32 maps
· Layer 3: reconstruction — 5×5, 출력 1 channel (기본 Y-channel 설정)
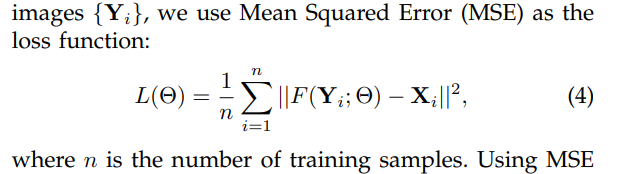
· Loss: MSE
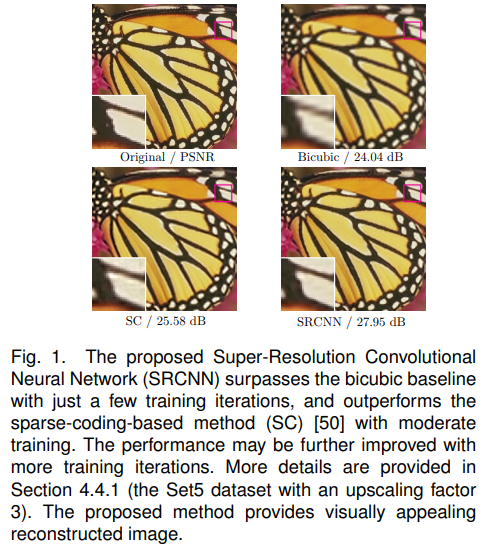
· 장점: 단순한 end-to-end CNN, 전통 방법보다 강한 복원 성능
· 한계 1: bicubic pre-upsampling 때문에 HR space에서 많은 연산
· 한계 2: shallow network
· 한계 3: MSE/PSNR 중심 → texture가 smooth해질 수 있음
질문 자체의 변화
“정답 픽셀에 가장 가까운 이미지”가 아니라 “사람이 봤을 때 진짜 고해상도 사진처럼 느껴지는 이미지”를 만들고 싶다면 loss를 어떻게 바꿔야 할까요?
이게 SRGAN
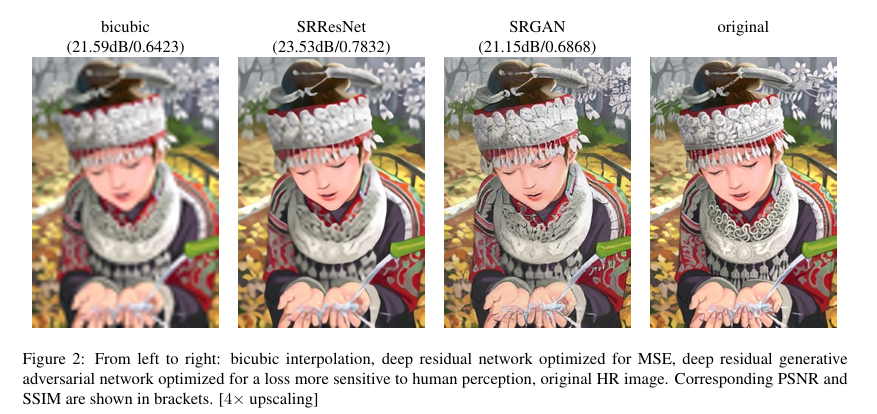
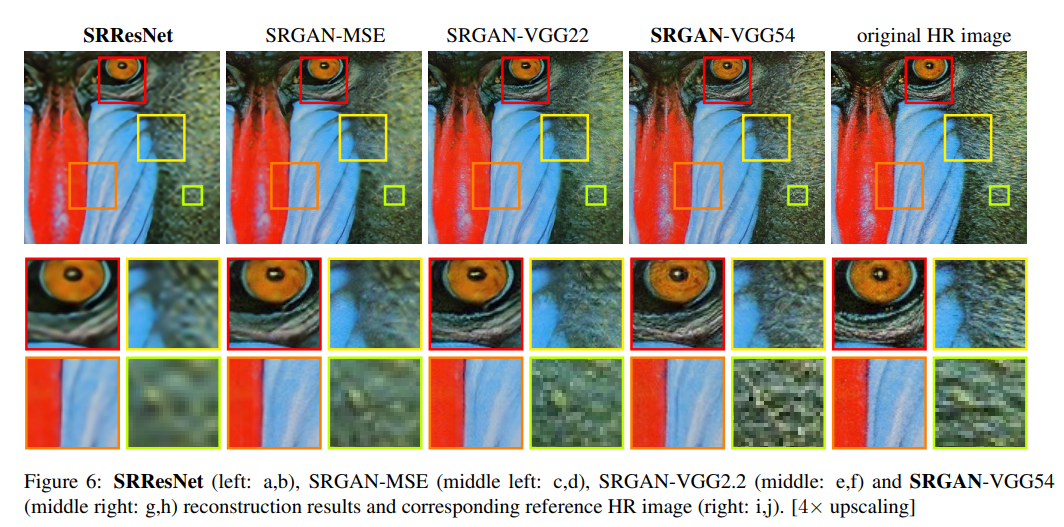
· SRResNet: MSE 최적화 → 높은 PSNR/SSIM, 그러나 smooth texture
· SRGAN: perceptual loss → PSNR이 낮아질 수 있지만 texture가 더 현실적으로 보임
· MOS(Mean Opinion Score)로 인간 평가도 수행
GAN 2분 복습: Generator와 Discriminator를 loss 관점에서 이해하기
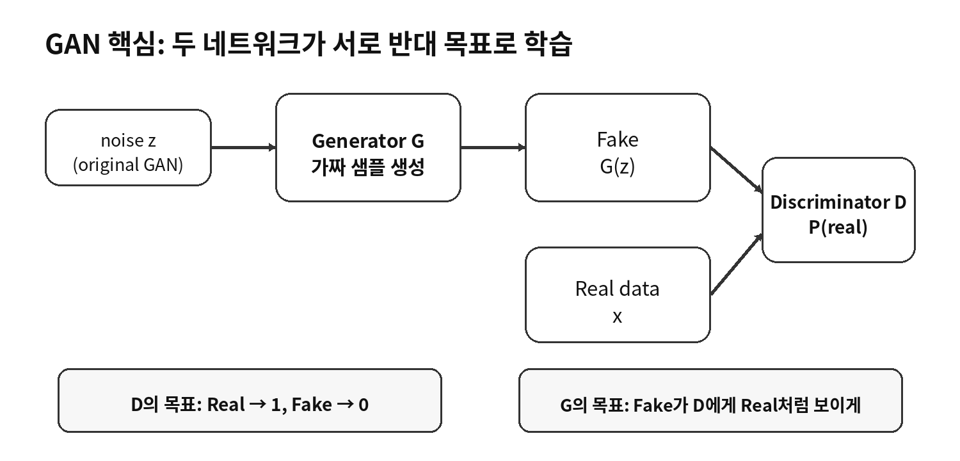
· Generator G: 원 GAN에서는 z → fake sample, SRGAN에서는 LR → SR image
· Discriminator D: real sample은 1, generated sample은 0에 가깝게 판별
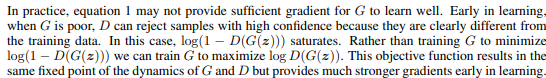
· 원 GAN의 핵심: min_G max_D E[log D(real)] + E[log(1−D(fake))]

· 실제 G 학습은 gradient가 강한 non-saturating 형태 −log D(fake)를 흔히 사용; SRGAN도 이 형태
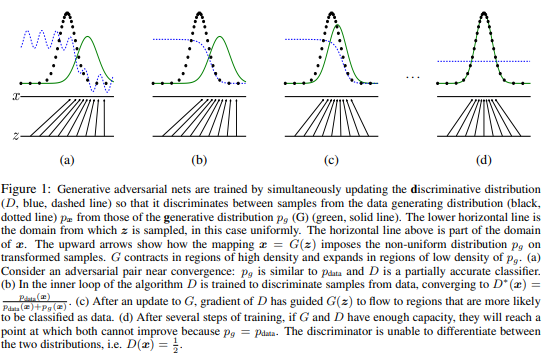
암튼 여기까지 정리하고,,, G와 D가 서로 반대 목적을 갖고 번갈아 학습한다 정도만 이해하면 오케이입니다.

SRGAN도 dversarial loss 하나만으로는 “이 SR이 입력 LR과 같은 장면인가?”를 충분히 강하게 보장하지 못하기에 그 대응관계를 붙잡는 것이 paired HR와 비교하는 content loss가 존재합니다. GAN과 같은 역할 분담이 존재하는 것이지요.
다만
원 GAN의 G는 random noise z를 입력받아 아무 이미지나 생성하지만, SRGAN의 G는 LR 이미지를 입력받아 그 LR에 대응하는 SR을 만듭니다. 즉 “무엇을 만들지”가 LR에 의해 조건화됩니다. 반면 SRGAN의 discriminator는 LR을 같이 보는 것이 아니라 real HR와 generated SR 자체의 real/fake를 구분합니다.
SRGAN architecture: 깊은 residual generator + discriminator
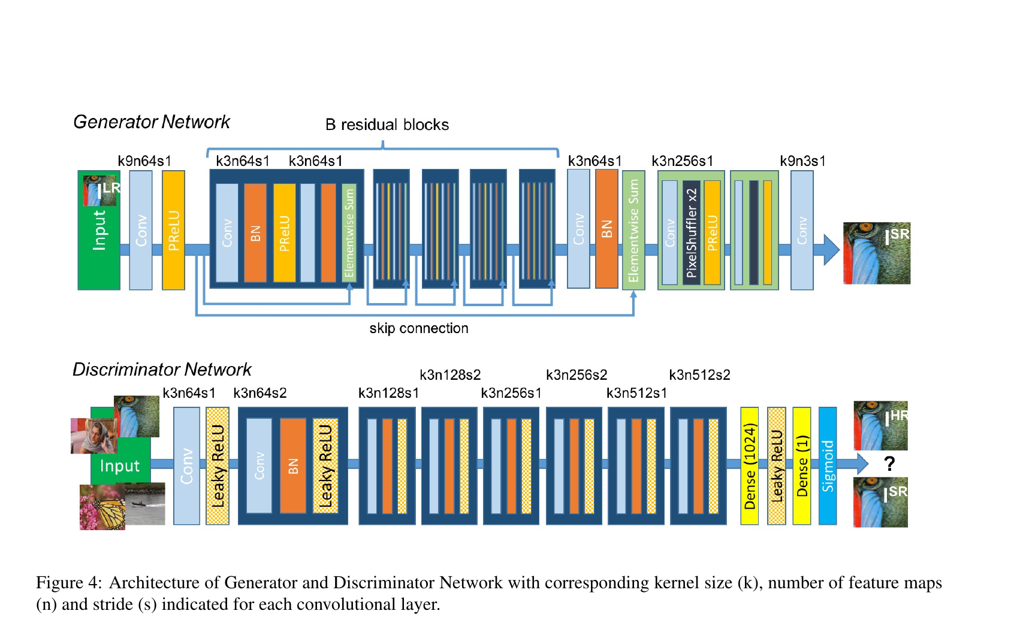
· Generator: 16 residual blocks (B=16)
· Residual blocks: Conv–BN–PReLU–Conv–BN + skip
· 2× PixelShuffle를 두 번 사용해 4× upscaling
· Discriminator: 8 convolutional layers, feature 64→512, stride로 downsampling

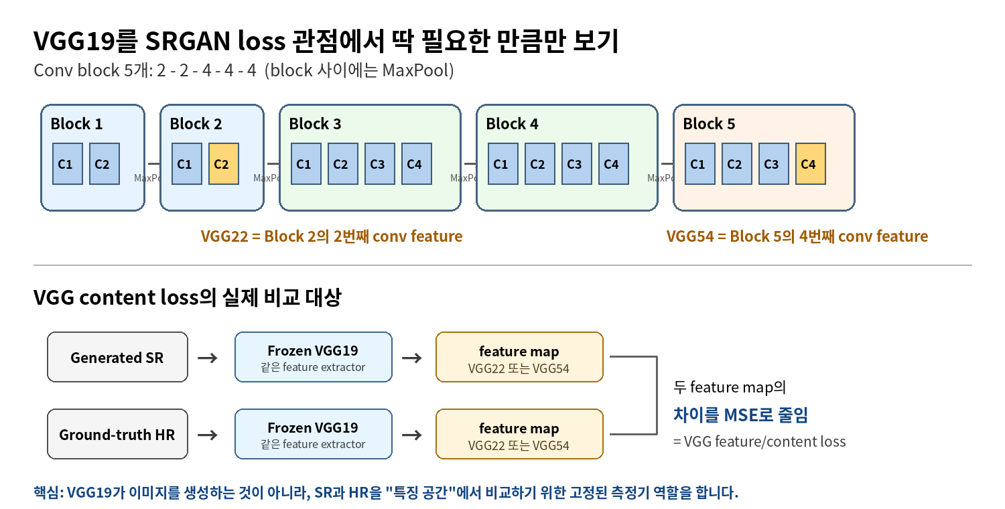
보조 설명: VGG19를 2분만 이해하고 SRGAN loss로 넘어가기
SRGAN의 핵심: Loss function을 정확히 분해해서 보기
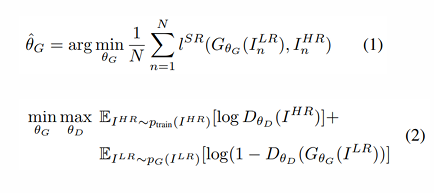
· ① Pixel/MSE loss: SR과 HR의 같은 위치 픽셀을 직접 비교 — fidelity/PSNR에 유리
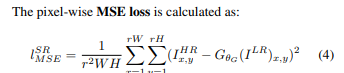
· ② VGG content loss: pretrained VGG19의 φ5,4 feature에서 SR과 HR을 비교
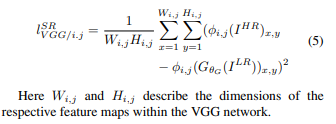
· ③ Generator adversarial loss: L_adv = −log D(G(LR)) — D가 SR을 real이라고 믿도록
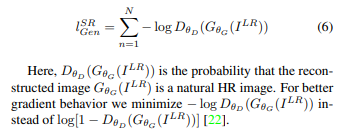
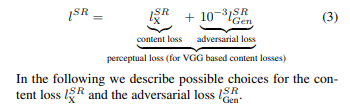
· SRGAN 논문 정의: L_SR = L_content + 10⁻³ L_adv; 여기서 “perceptual loss”는 이 전체 합
실험 결과
ESRGAN: SRGAN의 무엇이 부족했나
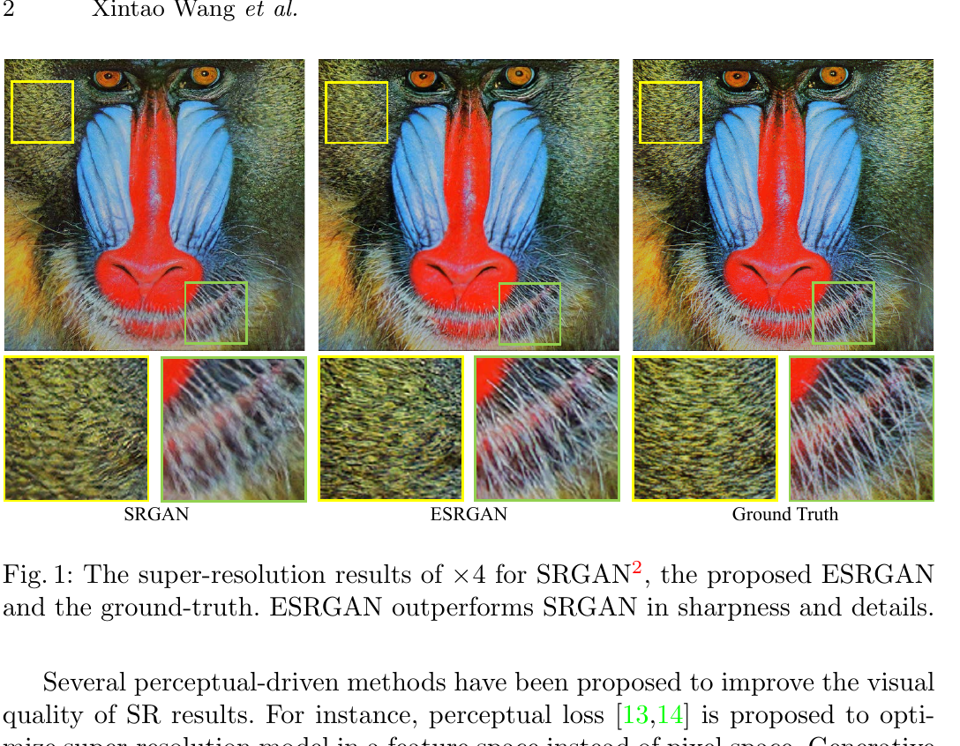
· SRGAN은 photo-realistic texture를 만들지만 unpleasant artifacts/hallucinated details가 생길 수 있음
· ESRGAN의 세 가지 개선축: ① network architecture( generator architecture ) ② adversarial loss ③ perceptual loss
· PIRM2018-SR Challenge region 3에서 1위
ESRGAN ① Architecture: BN 제거 + RRDB
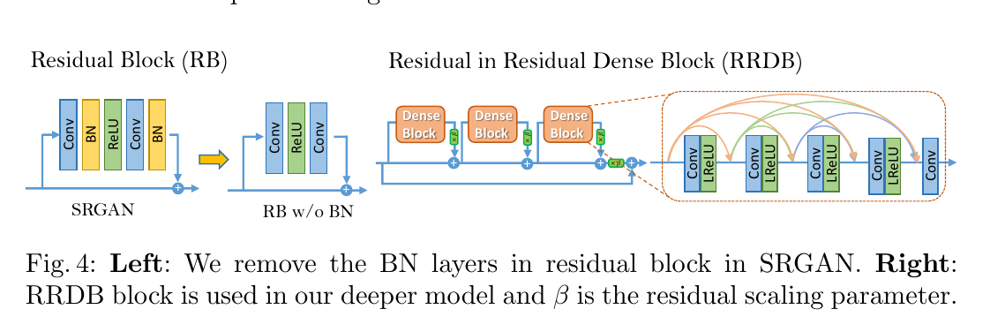
· SRGAN residual block의 BatchNorm 제거
· Residual-in-Residual Dense Block (RRDB) 사용
· Dense connections + multi-level residual learning
· residual scaling과 작은 initialization으로 deep network 안정화
· deeper 설정: 23 RRDB blocks
ESRGAN ②③ Loss 개선: RaGAN + pre-activation VGG + L1
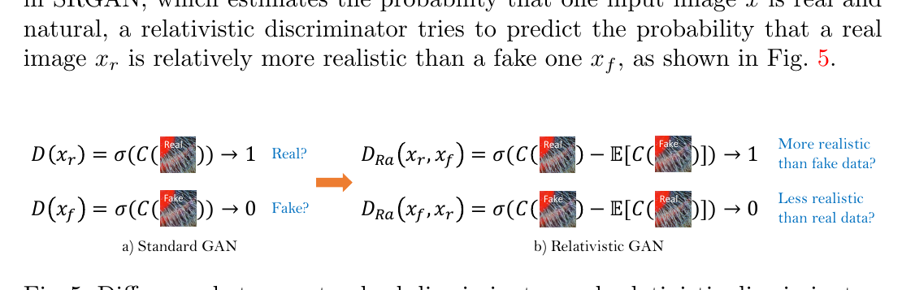
· Standard GAN: 각 이미지를 독립적으로 real/fake 판단
· RaGAN: “real이 fake보다 상대적으로 더 real한가?”를 학습
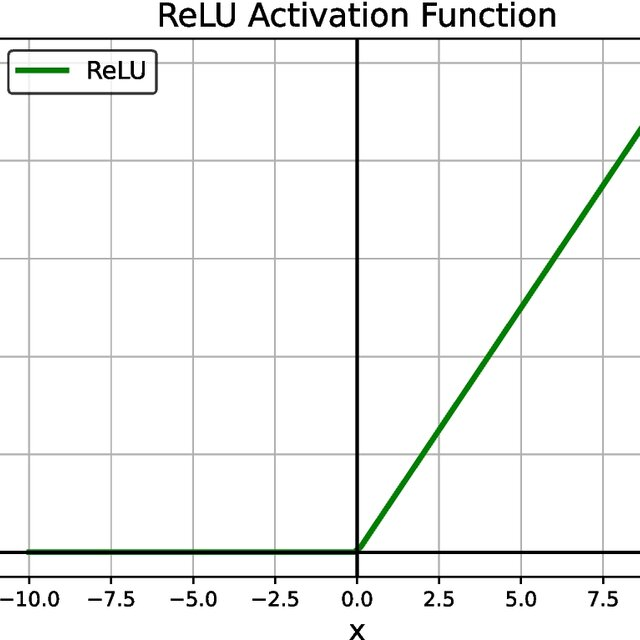
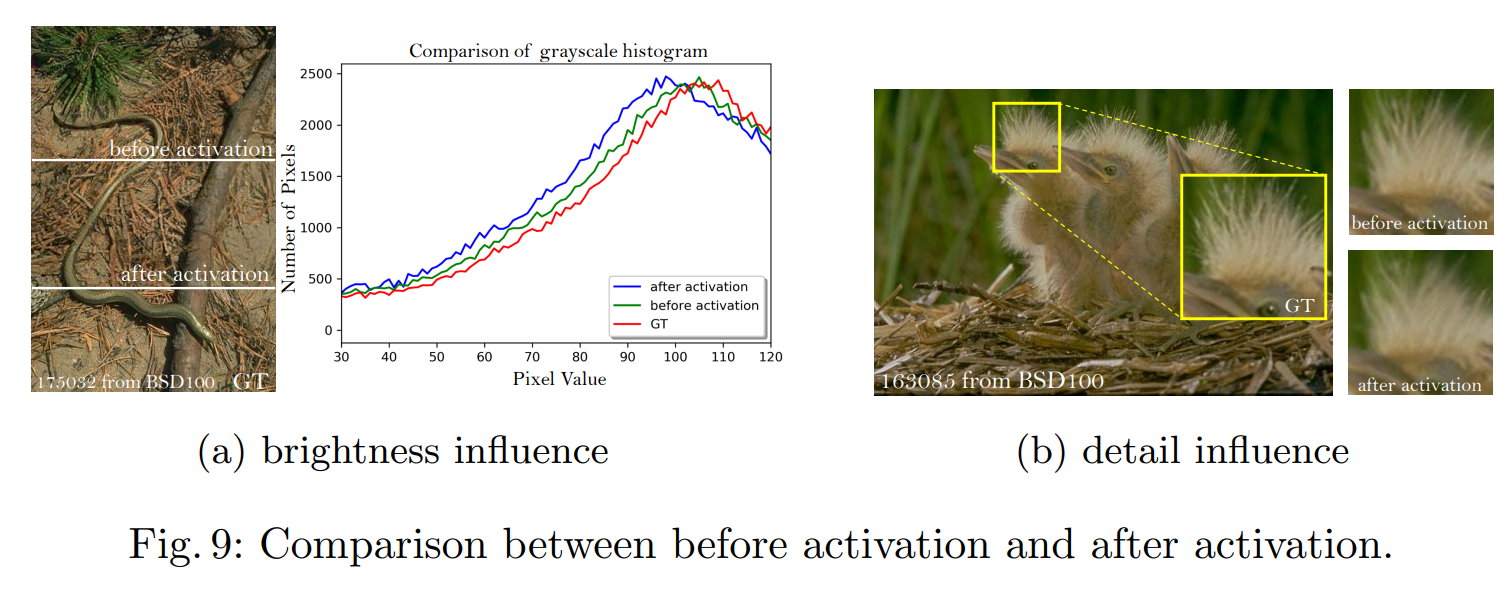
· VGG perceptual term: activation 이후가 아니라 activation 이전 feature 사용
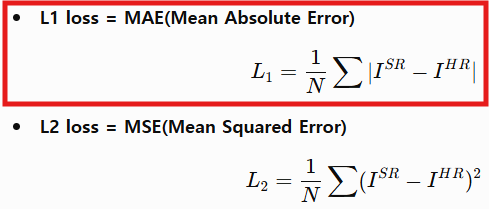
· Generator: L_G = L_percep + λL_G^Ra + ηL1, λ=5×10⁻³, η=10⁻²
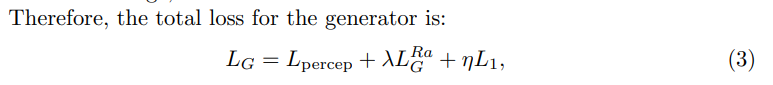
마무리
· SRCNN: “SR도 CNN으로 end-to-end mapping을 배울 수 있다.”
· SRGAN: “높은 PSNR보다 perceptual realism을 직접 최적화하자.”
· ESRGAN: “SRGAN의 generator · GAN loss · perceptual loss를 모두 개선하자.”