논문 제목: Segment Anything (SAM)
저자: Alexander Kirillov, Eric Mintun, Nikhila Ravi, Hanzi Mao, Chloe Rolland, Laura Gustafson, Tete Xiao, Spencer Whitehead, Alexander C. Berg, Wan-Yen Lo, Piotr Dollár, Ross Girshick
소속: Meta AI Research (FAIR)
학회지: ICCV 2023
0. Abstract
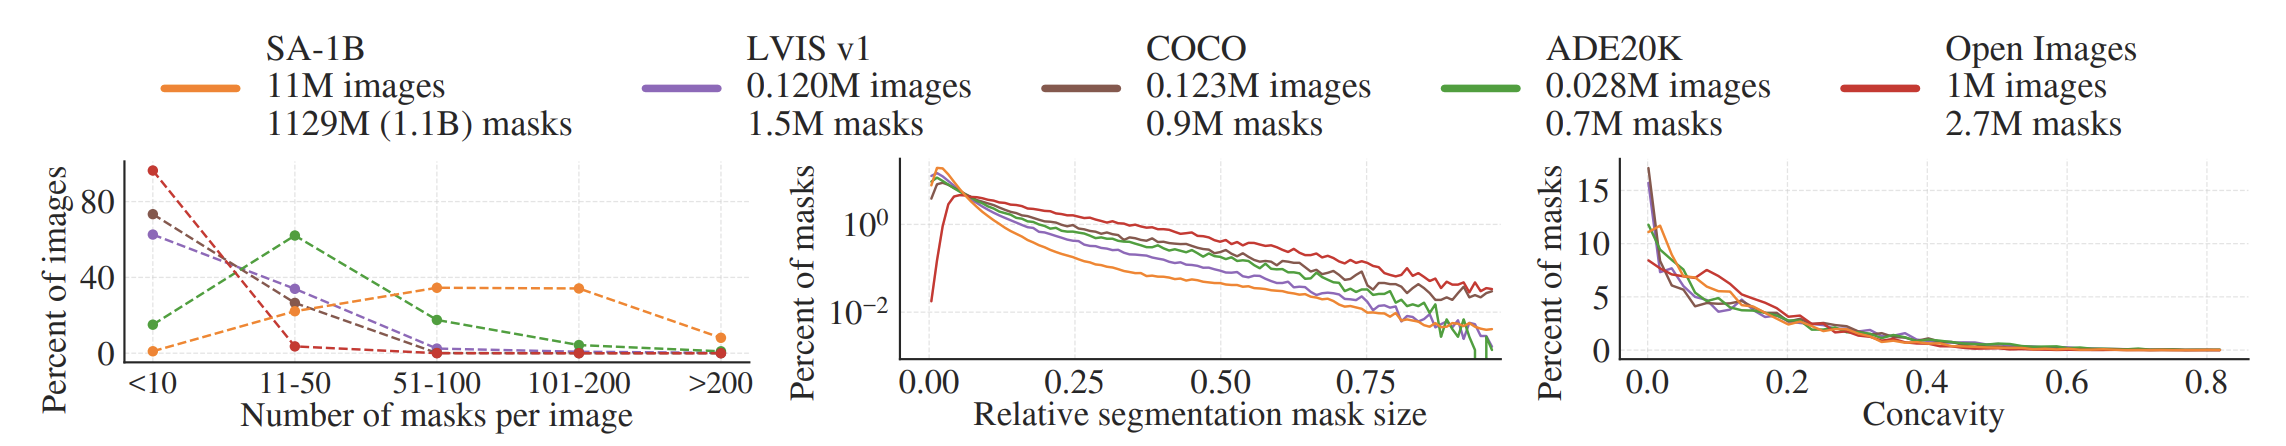
본 논문은 이미지 분할을 위한 새로운 task, model, dataset을 제안한다. 저자들은 promptable segmentation이라는 새로운 task를 정의하고, 이를 수행하는 Segment Anything Model(SAM)을 설계했으며, 데이터 엔진을 이용해 11M 이미지·1.1B 마스크로 구성된 역대 최대 규모의 분할 데이터셋 SA-1B를 구축했다. SAM은 다양한 다운스트림 task에서 재훈련 없이(zero-shot) 경쟁력 있는 성능을 보였다.
1. Introduction
NLP 분야에서는 GPT 같은 foundation model이 하나의 모델로 prompt engineering만으로 다양한 task를 처리한다. 저자들은 이 아이디어를 이미지 분할에 적용하고자 했다.
1) 어떤 task가 zero-shot 일반화를 가능하게 하는가?
2) 그에 맞는 model 구조는 무엇인가?
3) 이 task와 model을 학습시킬 data는 어떻게 구축하는가?
2. Segment Anything Task
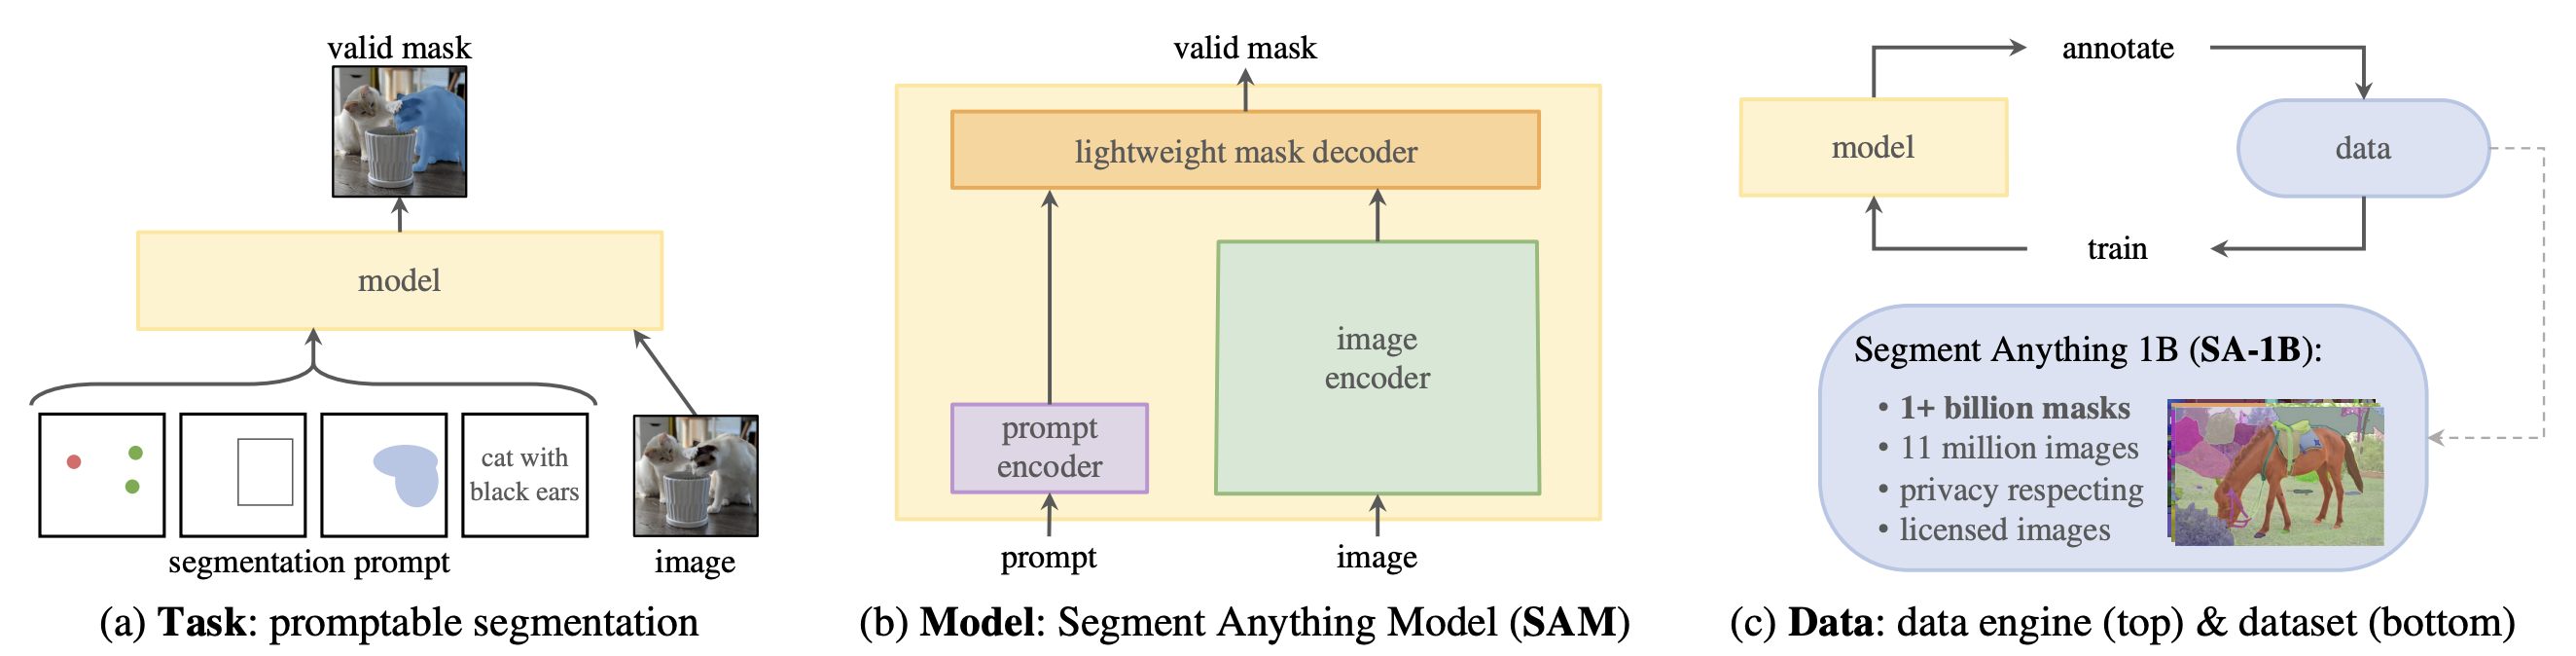
Promptable segmentation task는 어떤 프롬프트가 주어지든 valid한 분할 마스크를 반환하라는 task이다. 여기서 valid란, 프롬프트가 모호하여 여러 물체를 가리킬 수 있는 경우에도, 최소한 그 중 하나에 대해서는 말이 되는 마스크를 반환해야 한다는 뜻이다. 이 task는 pre-training의 목표로 쓰이는 동시에, 다양한 다운스트림 task에 prompt engineering으로 zero-shot 전이하는 통로가 된다.

3. Segment Anything Model (SAM)
SAM은 세 가지 컴포넌트로 구성된다.
- Image encoder: MAE로 사전학습된 ViT-H. 이미지당 1회만 실행되며 무거워도 무방
- Prompt encoder: 점/박스/텍스트는 positional encoding + 학습된 임베딩으로, 마스크는 convolution으로 인코딩.
- Mask decoder: 가벼운 2-layer Transformer 디코더로, 이미지 임베딩과 프롬프트 임베딩을 cross-attention으로 결합해 마스크를 예측. 이미지 임베딩을 캐싱해두므로 프롬프트당 약 50ms 만에 마스크가 나옴.
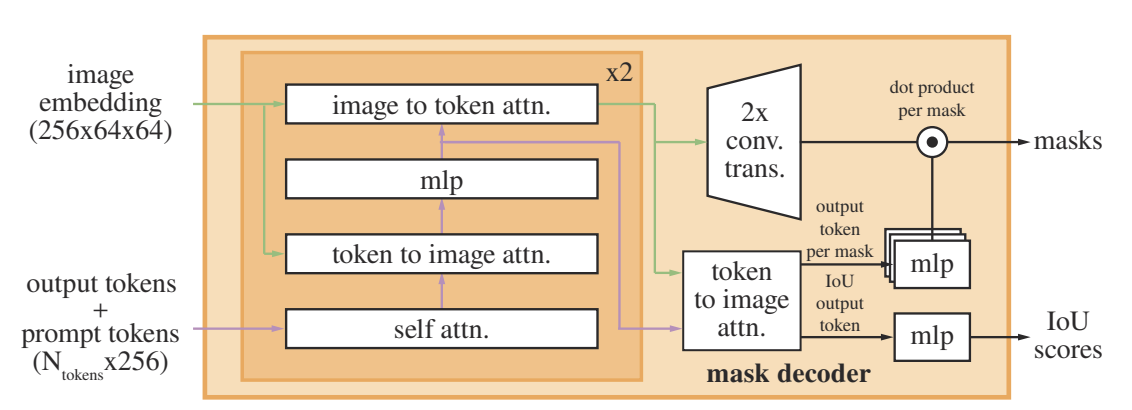
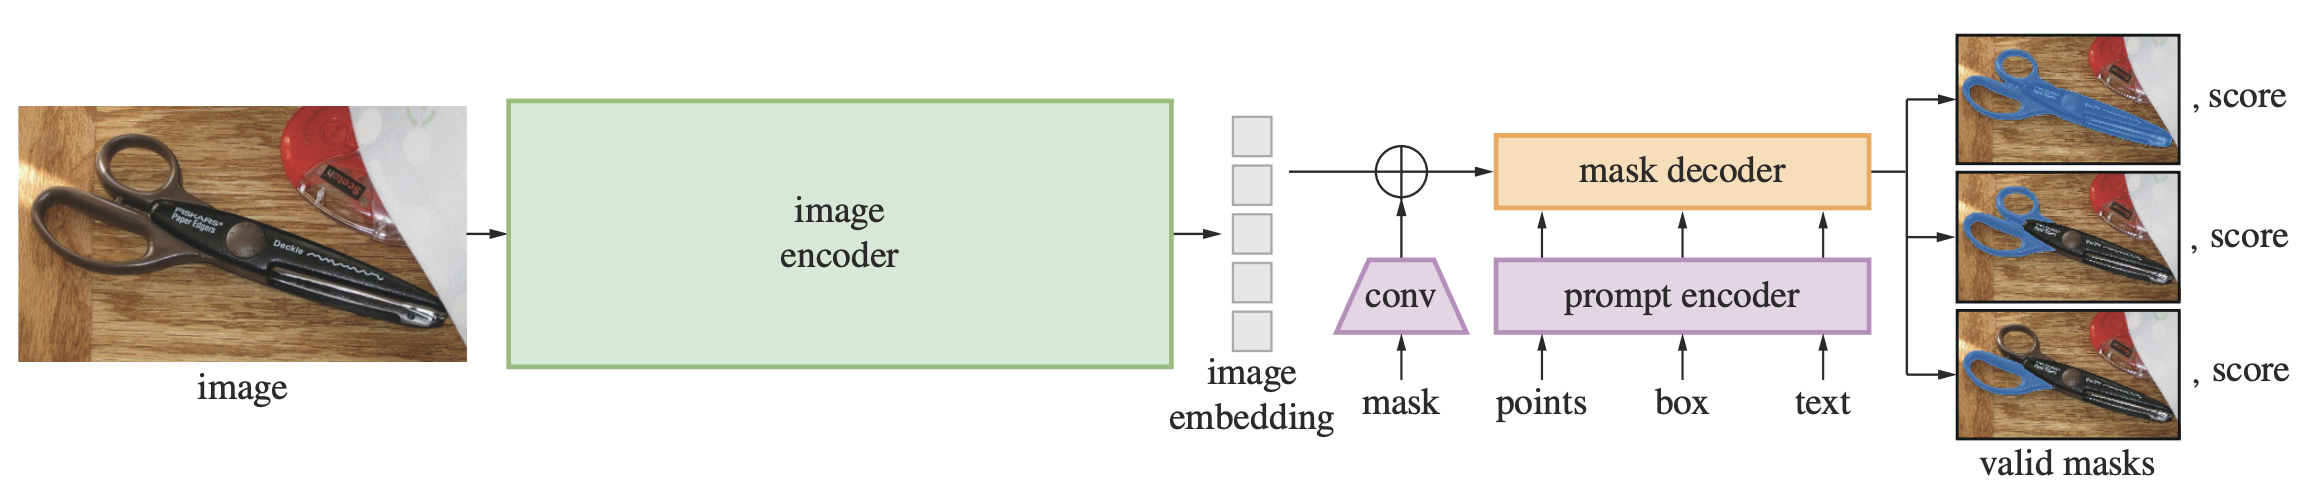
모호성 처리를 위해 하나의 프롬프트당 3개의 마스크를 동시에 예측하고, 훈련 시에는 그 중 정답과 가장 가까운 것의 loss만 역전파
마스크 예측의 손실함수는 focal loss와 dice loss를 20:1 비율로 선형결합한 것이다.
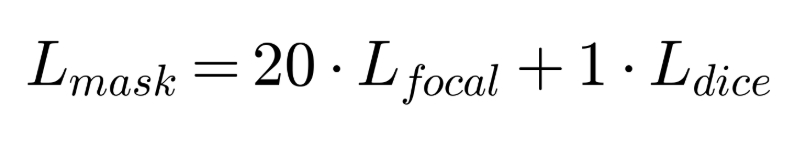
또한 여러 개의 후보 마스크의 품질을 평가하고 순위를 매기기 위해 IoU(Intersection over Union)를 사용한다.
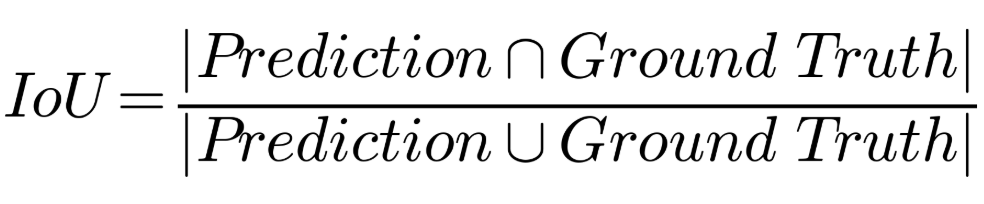
4. Segment Anything Data Engine
세그멘테이션 마스크는 웹에 자연적으로 풍부하지 않으므로, 저자들은 모델과 데이터를 번갈아 개선하는 data engine을 구축했다. 3단계로 구성된다.
1) Assisted-manual stage: 전문 어노테이터가 SAM의 도움을 받아 클릭으로 마스크 생성 (4.3M 마스크, 120k 이미지)
2) Semi-automatic stage: 자동으로 confident한 마스크를 먼저 깔아주고, 어노테이터는 덜 두드러진 나머지 객체만 라벨링하여 다양성 확보 (누적 10.2M 마스크)
3) Fully automatic stage: ambiguity-aware 모델이 32×32 격자 점을 프롬프트로 사용하여 완전 자동으로 마스크 생성 (최종 1.1B 마스크, 11M 이미지)
5. Segment Anything Dataset (SA-1B)
SA-1B는 11M개의 고해상도·라이선스 확보·프라이버시 보호 이미지와 1.1B개의 고품질 분할 마스크로 구성된다. 마스크의 99.1%는 완전 자동 생성되었으며, 전문가 보정본과 비교했을 때 94%가 90% 이상의 IoU 일치를 보여 품질이 충분히 검증되었다.
6. Zero-Shot Transfer Experiments
SAM이 훈련받은 것은 오직 promptable segmentation task 하나뿐이지만, prompt engineering만으로 재훈련 없이 다양한 task를 풀 수 있다.
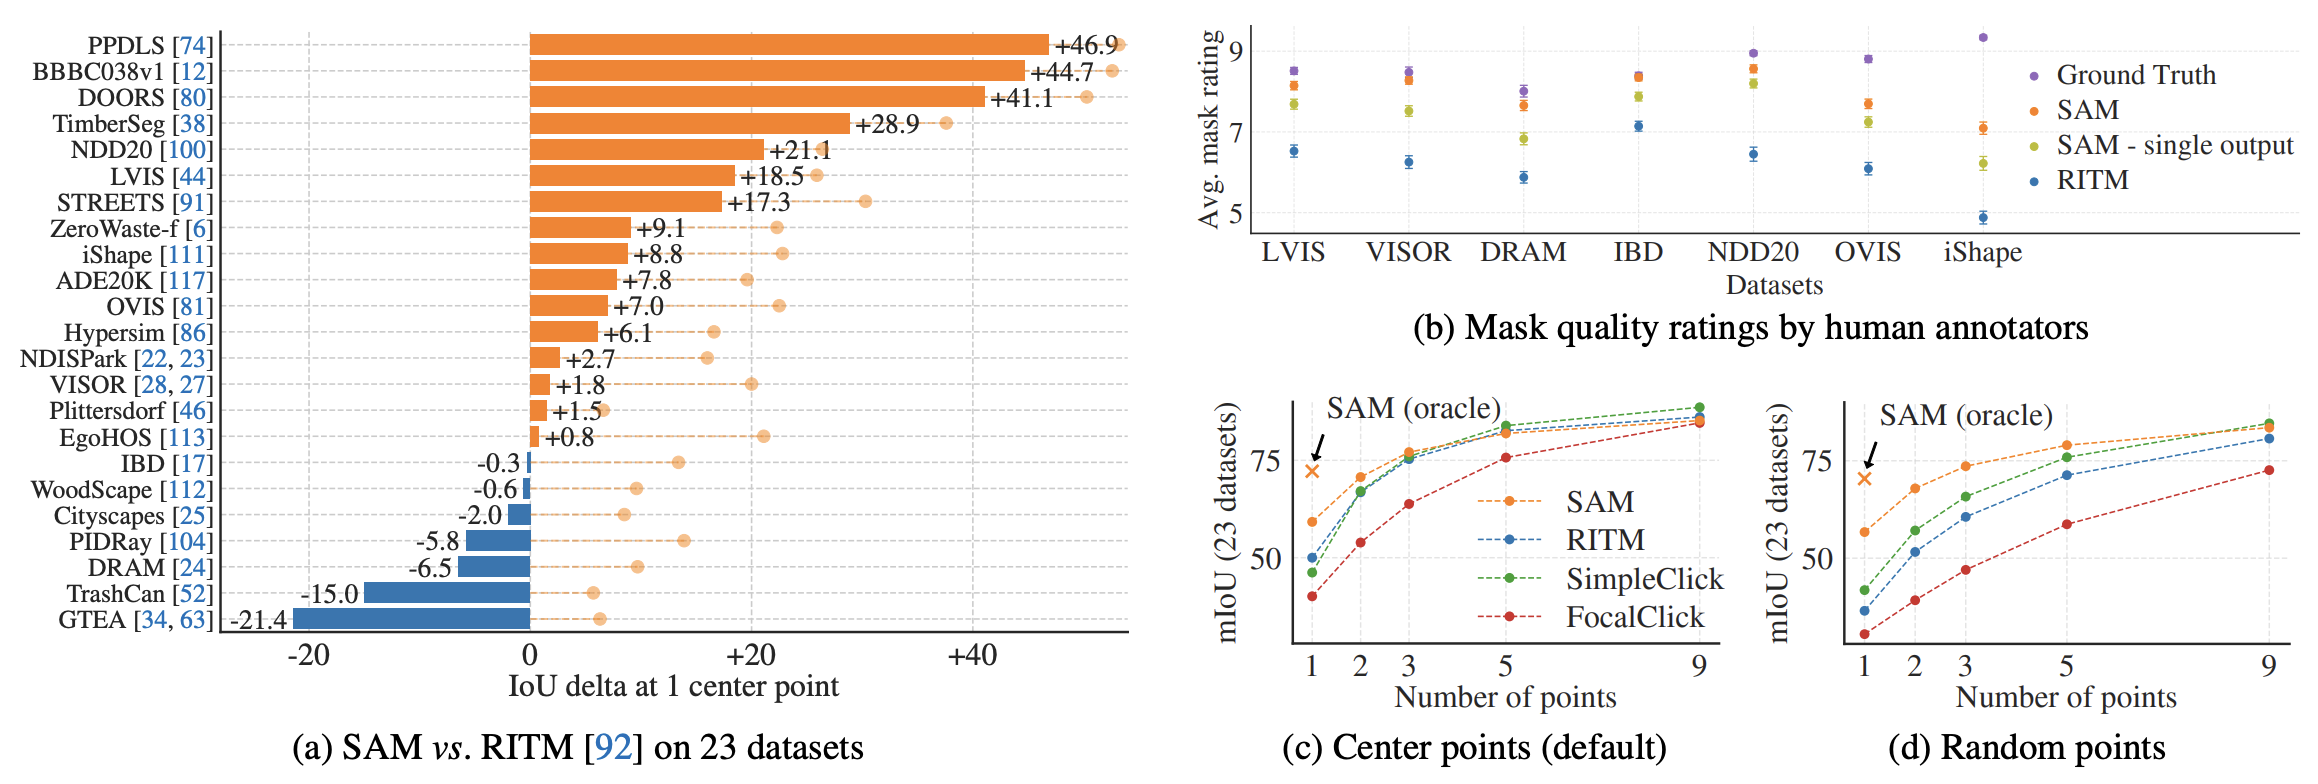
(1) Single point → mask: 23개 데이터셋에서 단일 점 프롬프트만으로 마스크 품질을 평가한 결과, 기존 최강 baseline인 RITM보다 16/23개 데이터셋에서 우수했으며, 사람이 직접 평가한 human study에서도 SAM의 마스크 품질이 일관되게 더 높게 평가되었다.
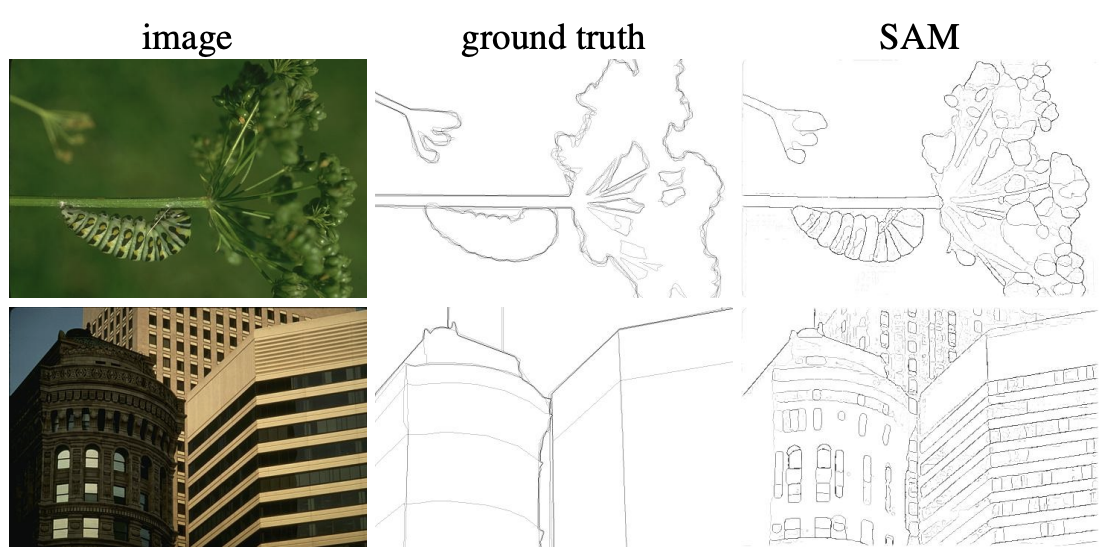
(2) Edge detection: 16×16 격자로 점을 뿌려 마스크를 생성하고 경계를 추출하는 방식으로 BSDS500에서 평가한 결과, edge detection을 학습한 적 없음에도 합리적인 edge map을 생성했다.
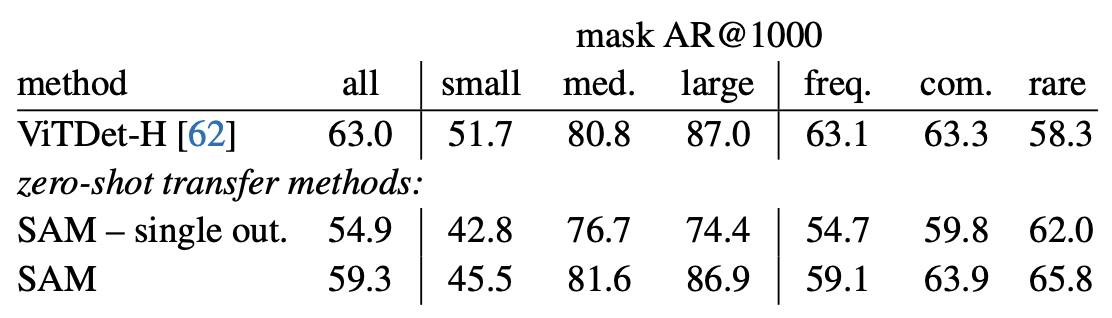
(3) Object proposal generation: LVIS v1에서 자동 마스크 생성 파이프라인으로 물체 후보를 생성한 결과, 중대형 물체 및 rare/common 카테고리에서 ViTDet-H보다 우수한 성능을 보였다.
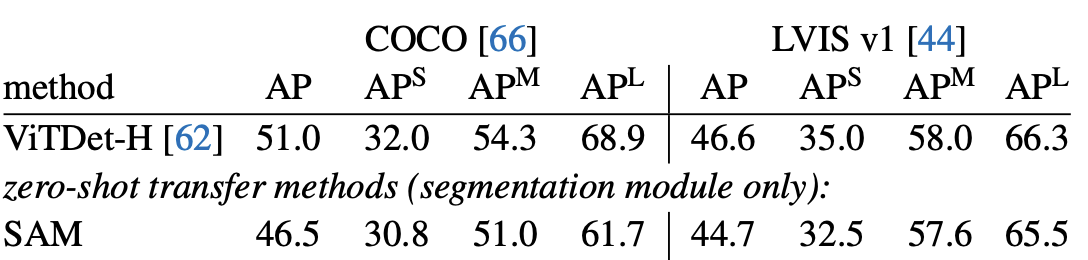
(4) Instance segmentation: ViTDet이 제공한 박스를 SAM의 프롬프트로 사용하여 물체별 마스크를 분리했다. AP 지표는 완전지도학습 모델인 ViTDet보다 낮았지만, human study에서는 SAM의 마스크 품질이 오히려 더 높게 평가되었다(ViTDet이 훈련 데이터의 편향을 학습했기 때문으로 추정).
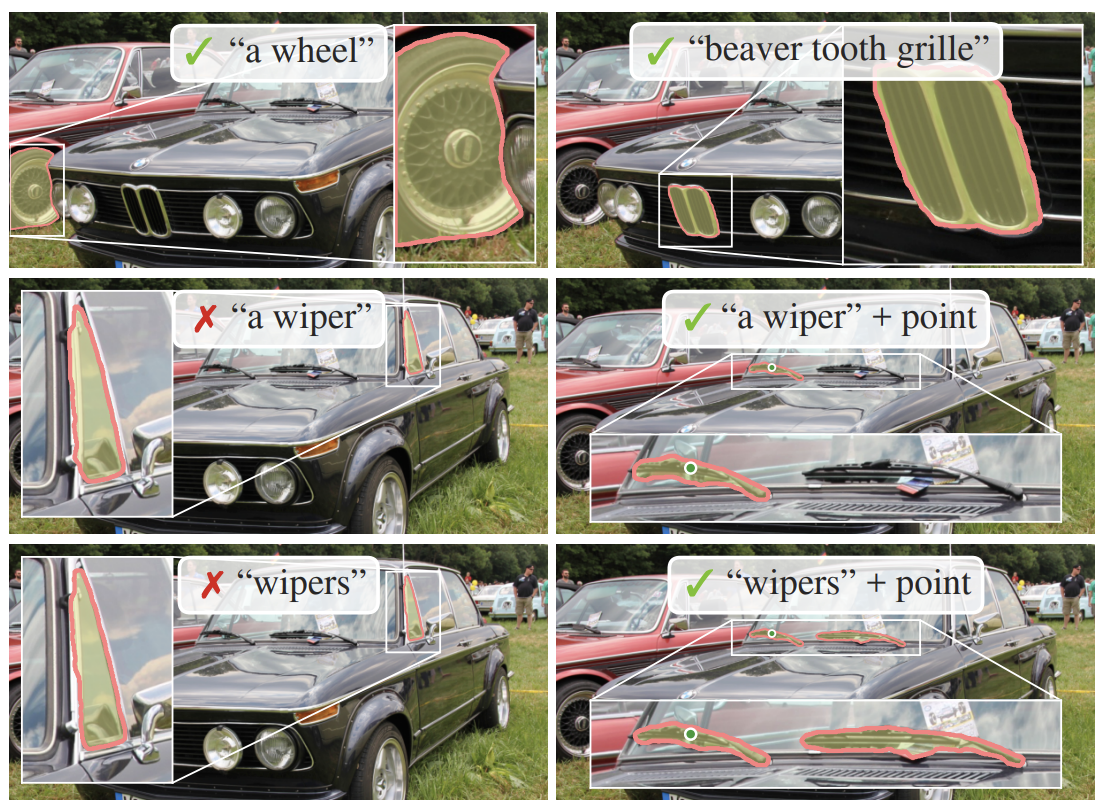
(5) Text-to-mask: CLIP의 이미지-텍스트 임베딩 정렬을 이용해, 텍스트 프롬프트만으로 물체를 분할하는 proof-of-concept 실험을 수행했다.
7. Ablations
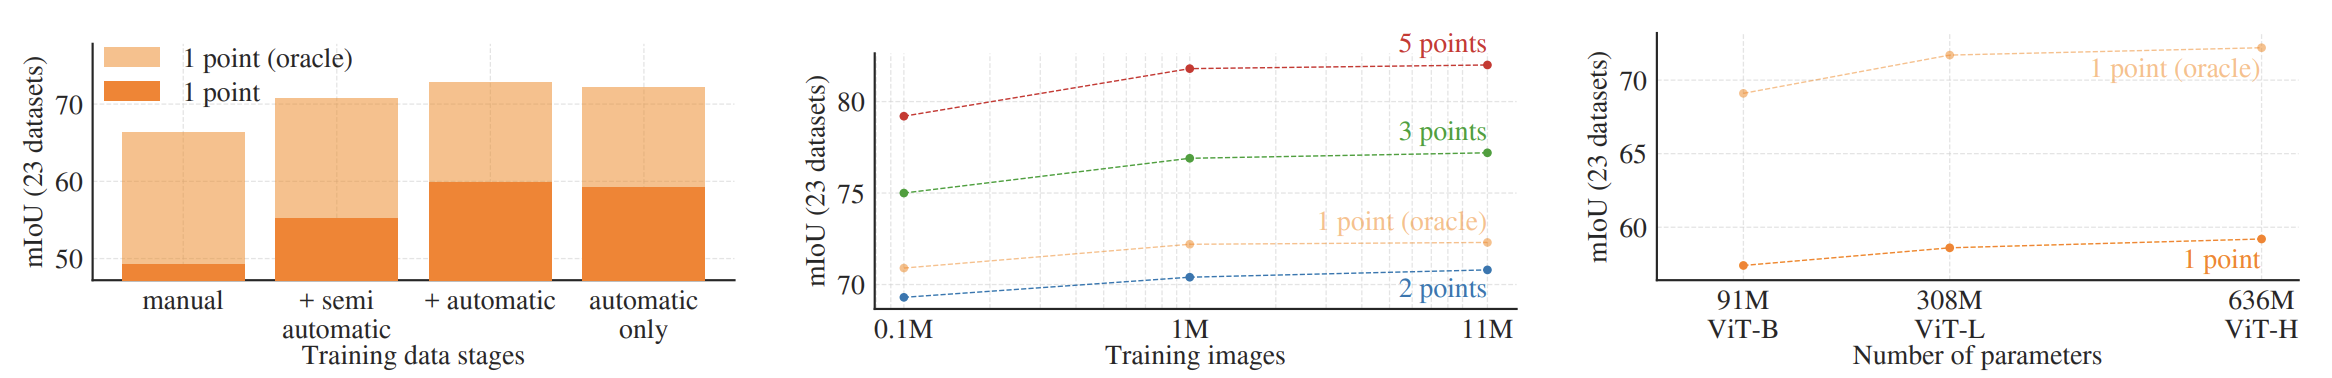
데이터 엔진 단계별 누적 학습 효과, 학습 이미지 수, 이미지 인코더 크기(ViT-B/L/H)에 따른 성능 변화를 분석했다. 완전 자동 생성 마스크만으로 학습해도 전체 3단계 데이터를 다 사용한 것과 거의 동일한 성능(약 0.5 mIoU 차이)을 보였으며, 전체 데이터의 약 10%(1M 이미지)만으로도 전체 데이터셋과 비슷한 성능을 냈다.
8. Discussion & Limitations
SAM은 얇은 구조물을 놓치거나 작은 조각을 환각하는 등의 한계가 있으며, 많은 포인트가 주어지는 상황에서는 전용 interactive segmentation 모델에 뒤처질 수 있다. 또한 semantic/panoptic segmentation을 위한 간단한 프롬프트 설계는 아직 불명확하다. 그럼에도 저자들은 promptable segmentation task, SAM 모델, SA-1B 데이터셋이 이미지 분할을 foundation model 시대로 이끄는 계기가 될 것으로 기대한다고 결론짓는다.